关于 Paxos 以及分布式 KV
Paxos 是一个共识算法,在 CAP 理论中显然属于 CP。
Quorum 指的是多数派,多数派的定义是所有节点的多数,例如所有 个节点中的任意 个节点。按照鸽巢原理,同一集合中的两个多数派必然有交集,如果每个节点只能认定一个 Proposer,那么只有一个 Proposer 能够获得多数派支持,这是共识算法的基石。
见 MIT6-824 Split Brain 和 MIT6-824 Majority Vote,但是 Paxos 是在 2015 年的时候的 Lab,之后被替换成 Raft 了
根据设计需要,共识内容一旦被决定就不能被修改,这意味着最初 Proposer 所提议的内容一旦被确定,则后续 Proposer 必须按照当前共识来提议。提议是为了维护共识,而不是提议新的内容(除非第一次提议),这非常重要!
在崩溃共识算法里面,故障有两种:
- 崩溃故障:节点可能会崩溃
- 网络故障:节点可能连不上某些其他节点
接下来试着演化一下 Paxos 是怎么设计出来的:
前提条件:所有节点对等,均可成为 Proposer 和 Acceptor,且已知所有节点 peers,每个节点都有一个唯一的 ID,非拜占庭错误(无恶意节点)
假设有 A 和 B 两个节点,一开始 A 和 B 为空,其中 A(Proposer)向 B(Acceptor)想要提议值 ,则 A 向 B 发送一个 Accept 消息。如果 B 已有值则拒绝并返回自己的值 ,否则接受并回复 Accept-Ack 消息。若 B 拒绝,则 A 设置自己的值为 ;若 B 接受,则 A 设置自己的值为 。
为了高可用,必须有多个 Acceptor,增加到 个节点。
此时添加 Proposer,假设有五个节点,其中有两个 Proposer P1 和 P2 都希望提议自己的值 和 ,P1 和 P2 分别已经 Accept 了 和 ,分别还收到了 和 的拒绝消息,而 E 不可用,则 P1 和 P2 都不认为自己提议成功(凑不齐三个节点的多数派),因此 Acceptor 在接受了值之后,必须可以允许被继续更改,而不是一律拒绝。
刚刚是“前者拒绝后来者”,如果 Acceptor 遵循“后来者覆盖前者”的原则,那么按照以下情况:P1 先 Accept 了 ,P2 然后 Accept 了 ,都觉得自己的提议成功了,那么共识从 P1 的值 变为 P2 的值 ,也不可以,共识被修改了。
如果添加写前先读的机制,增加 Prepare 阶段,让 Acceptor 回复自己的值,Proposer 在 Prepare-Ack 回复中采集 Acceptor 的值,如果发现有值,则 Proposer 必须放弃自己的提议的值,改为 Acceptor 的值,这样就能维护共识。
如果之前一个 Proposer 只写入了一个 Acceptor 就崩溃了,另一个 Proposer 在之后也只写入了一个 Acceptor 也崩溃了,那么现在 Proposer 将采集到两个不同的值,如何选择呢?显然需要一个规则来定义优先顺序。
我们设计一个单调递增的唯一 Proposal ID,每个 ID 对应一次 Propose(对于单个 Proposer 来说是单调递增,对于全局来说有唯一性)。这样的设计并不难,例如 [Increment][Peer ID] 就可以在不互相通信的情况下保持唯一性),Accept 消息中附带 ID。每当 Acceptor 写入值时就一同记录下对应的 ID 到 AcceptProposalID,之后 Proposer 在采集到多个值时,选择 ID 最大的值作为自己的提议值。(至于为什么是最大,见后文)
此外,在并发操作中总是会有*Check-Then-Act(检查后执行)*的问题。例如:
P1 Prepare A1, A2, A3 —> 回复无共识
P2 Prepare A3, A4, A5,此时 A3 还未收到 P1 的写入,回复无共识
P1 写入 A1, A2, A3 (V1) —> V1 达到多数派,被认为提案成功
P2 写入 A3, A4, A5 (V2) —> P2 Prepare 时认为可以写入,向 A3, A4, A5 写入 V2 —> A3 再次被写入!
在 P2 的 Check 和 Act 之间,被 P1 抢先 Act。
显然这里需要锁机制。利用先前设计的 Proposal ID,在 Prepare 阶段实现 Promise 机制:在 Prepare 消息中附带本次 Propose 的 ID,Acceptor 在收到 Prepare 消息后,如果 ID 大于自己上次承诺的 PromiseProposalID,则承诺本次 Propose,将 PromiseProposalID 设置为本次 ID。之后只接受 ID 大于 PromiseProposalID 的 Prepare 或大于等于 Accept 消息。
在单机并发中,解决读后写竞争可以加
mutex,但在分布式系统中不能依赖死锁风险极高的mutex(这是 Gemini 觉得的,我还没看过这么多设计,不能下定论)
现在就不会有被抢先写入的问题了:
P1 Prepare A1, A2, A3 (ID=10) —> A1, A2, A3 承诺 ID=10
P2 Prepare A3, A4, A5 (ID=5) —> A3 拒绝 P2 的 Prepare 消息,P2 需要重新发出更大 Proposal ID 的 Prepare
P1 写入 A1, A2, A3 (V1) —> V1 达到多数派写入,被认为提案成功
P2 重新 Prepare A3, A4, A5 (ID=15) —> A3, A4, A5 承诺 ID=15
对于 Accept 消息,显然要允许等于,因为 Prepare 阶段设置过 PromiseProposalID 了
为什么是最大?选取最大编号,就等价于继承了最后获取多数派支持的 Proposer 的提案值。先前该 Proposer 可能未完成对所有节点的写入,对应收集到多个不同值的情况;假如已完成,则应该只有一个可选值(无故障);显然如果无值可选,则对应的是之前还没有 Proposer 能够对任意节点完成 Accept 阶段的情况。(可见节点是对于当前 Proposer 可见)
注意
AcceptProposalID和PromiseProposalID可能是不同的,前者是 Acceptor 接受的值对应的 Proposal ID,后者是 Acceptor 承诺 Proposer 的 Proposal ID。AcceptProposalID仅用于挑选提案值时提供参考。
那么 Prepare 阶段也就是有两个功能:排他承诺和采集先前共识。
以上就是 Paxos 的大概设计,以下是 6.824 Lab 3: Paxos-based Key/Value Service 提供的伪代码:
1 | proposer(v): |
上面完全没考虑各种可能的故障和异常情况,累了 =-=
显然上面的都是我自己的理解,当然是不严格的,仅供参考。
有论文作者的 Paxos Made Simple 可以参考,实际上作者论文里面是用三个 Agent(Proposer、Acceptor、Learner)来描述的,里面还有作者的证明(但我没太看懂)。
Wikipedia 上有 Paxos_(computer_science),里面有很多例子,以及课程的 Notes l-paxos 中也有几个例子。
那么如何利用它来构建一个分布式 Key/Value 存储呢?2015 年之前的 MIT6.824 提供了 Lab 3: Paxos-based Key/Value Service,里面有项目框架和测试。
总体来说,Paxos 的共识决定之后就无法改变,显然没法把整个 Map 当作一个值来提议,无法改变 Map 的内容。
但是按照 RSM (Replicated State Machine) 的思想,我们只需要维护一份相同的日志序列即可。客户端可以将操作发送给任何服务器,试着将操作写入到日志末尾。每行日志对应一个 Paxos 实例,节点间通过 Paxos 协议,来协商指定日志行要执行的操作,并将该操作作为值记录到 Paxos 实例中。服务器按照日志中的顺序执行这些已协商好的操作,应用到服务器的本地状态机上。由于所有服务器都执行相同的操作序列,因此它们的状态机最终会保持一致。
类似于 TCP 的 Ressembler,日志必须从开头一直往后连续才能被状态机应用,中间可能有空洞(仍未决定,或者占据该槽位的 Poposer 未完成提议),此时可以试着提议一个 NOP 来填充空洞,如果其他节点已有共识则认可,以免其他操作一直被空洞阻塞无法应用。
更进一步,可以应用 Mutil-Paxos 进一步优化,将 Proposer 固定住,增加 Leader 身份,省去了每次都要 Prepare 的开销,Leader 只需要在第一次提议时 Prepare,之后的提议直接 Accept 即可。
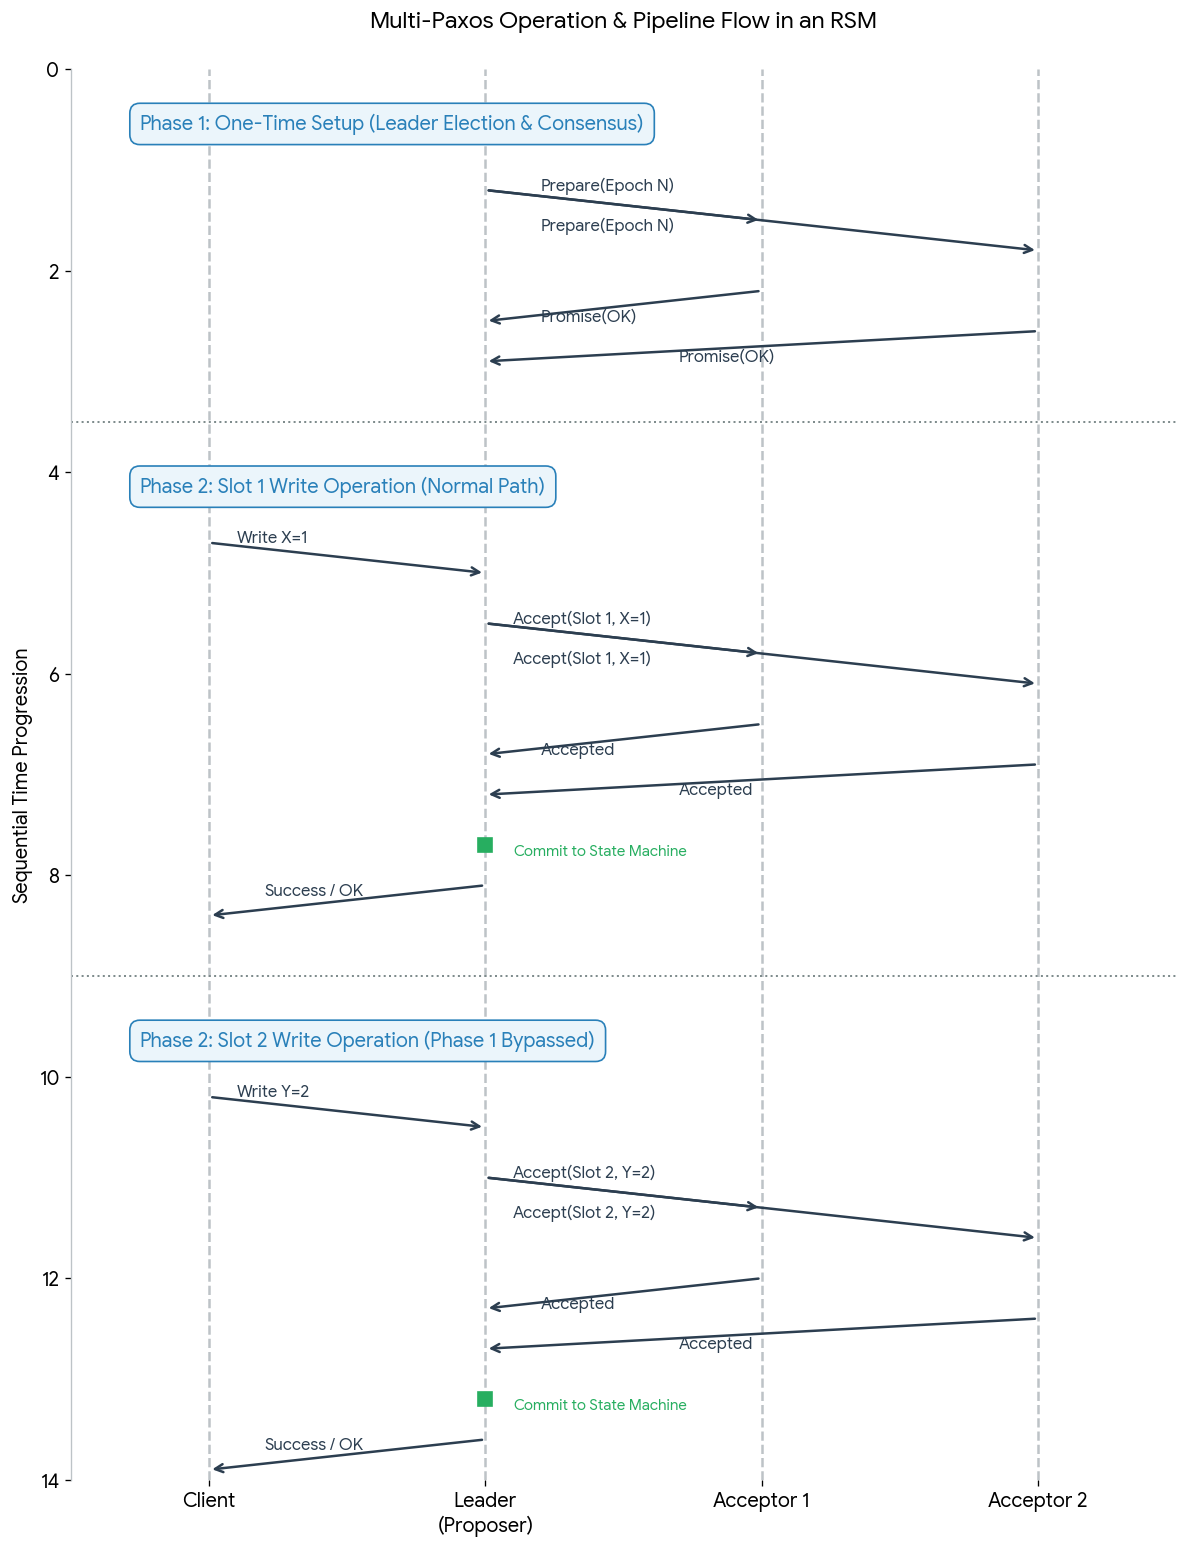
也许会觉得单一 Leader 将导致所有请求都必须经过它,而成为性能瓶颈。虽然 RTT 从 2 次减少到 1 次,但 Leader 仍然需要处理所有请求,显然还是有瓶颈的。6.5840 Lab 5: Sharded Key/Value Service 是关于分片的,显然将请求映射到不同的 Leader 上可以缓解瓶颈问题。
显然这里还有很多要考虑的,比如旧 Leader 崩溃后新 Leader 在恢复时要如何采集之前错过的日志,Follower 崩溃后错过了的日志要如何补齐,如何压缩日志(日志会无限增长)、传递快照等等。
这里有 Google TechTalks 关于 The Paxos Algorithm 的视频,以及 Paxos Made Live - An Engineering Perspective 里面有 Google 的生产应用。
Google 的还没来得及看…
个人感觉,Paxos 不说证明的话,还是很好理解的。但是实际实现起来就会有诸多 Bug,根本不知道咋去修,也不知道实现测试框架 =-=
我这里有一份实现 feat: paxos,在完成了基础 Paxos 之后就直接让 Codex 写测试了,离开了课程提供的测试框架之后根本不知道咋写测试 emmm,是个大问题。至于 Multi-Paxos 的实现,我自己写了一份,但是非常混乱,基本上被 Codex 重构完了…最后 Codex 补充了日志压缩快照和崩溃拉取的功能。Google 的文章里面似乎说到他们直接写状态机然后生成代码实现,还有测试框架…TODO
说些什么吧!